

 首页>
AI训练师三级考试里,模型评估与调优几乎年年出题。准确率、召回率、F1、混淆矩阵、过拟合欠拟合,这几个词长得像,其实特别容易混。这篇把它们一次讲清楚,顺带说考场里到底怎么考。
一、训练集验证集测试集,先把数据切对
模型调优这件事,第一步不是调参数,是把数据分好。我带过的学员里,一上来就堆模型、改参数,最后评估分数忽高忽低,十有八九根子在数据划分上。
为什么非得留三份?拿全量数据一把梭的人,理由很朴素:数据本来就少,再分不就更少了。问题是你不分,根本不知道模型在没见过的数据上表现如何。训练分数再高,也只能说明它把这批数据记住了,不能说明它学会了规律。
标准做法是把标注好的数据切成三份。训练集拿来喂模型,让它学规律;验证集拿来调参数,选哪个模型、取多少特征都靠它拍板;测试集留到最后,验收的时候才碰。常见的切分比例是6:2:2,也有7:2:1,怎么切看你手头数据量大小,数据少就多分点给训练集。
这里最容易踩的坑,是拿测试集去调参。你拿测试集的分数反过来改模型,等于提前偷看考卷答案。纸面分数挺好看,模型一上线遇见新数据就露馅。考试里这种题特别爱出,给你一段工作流程的描述,问你哪里不规范。记住一条死规矩:测试集只碰一次,碰完就锁起来。
切数据还有两个细节。一是别按原始顺序直接切,先打乱再分,不然数据是按时间或类别排好的,训练集和测试集长得不一样,评估就失真。二是类别不均衡时用分层抽样,保证训练集和测试集里正负样本的比例差不多。这两点考试不常直接考,但实操考核里踩了这个坑,结果分数一塌糊涂,你都不知道错在哪。
数据量小怎么办?用交叉验证。把训练集切成几份,轮流当验证集,最后取平均分当参考。三级考试考到交叉验证,一般就是概念题,问它解决什么问题。你答它在数据少的时候评估更稳、结果不依赖某一次随机划分,这分就拿到了。
二、四个评估指标到底什么意思
准确率这个词外行都听过,考试里它恰恰最容易出错。别看着眼熟就不背,真做题时翻车的多半是它。
| 指标 | 一句话解释 | 什么时候最容易骗人 |
|---|---|---|
| 准确率 | 所有样本里判对的比例 | 样本类别不均衡时 |
| 精确率 | 报出来的正例里真有多少是对的 | 宁可多报也不漏报的场景 |
| 召回率 | 真实的正例里被抓出来多少 | 宁可错报也不能漏的场景 |
| F1值 | 精确率和召回率的调和平均 | 两个指标打架时拿综合分 |
举个例子你就懂了。做一个缺陷检测,1000个样本里只有5个真缺陷。模型啥都不学,全判正常,准确率还有99.5%。听着很漂亮吧?实际啥用没有。这就是为什么考试非要你把召回率也背下来,单看准确率会被打脸。
召回率说的是真缺陷里被你抓出来多少。医疗筛查、诈骗识别这种场景,宁可错杀不可放过,召回率就得拉满。精确率正好反过来,是你报出来的正例里真正确的占多少。推荐系统里它更要紧,推一堆垃圾给用户,人直接就卸载了。
F1是精确率和召回率的调和平均。两个指标打架的时候,用F1拿个综合分。考试常给你混淆矩阵的四个数,让你算F1。这种题纯送分,公式背熟,别算错除法就行。
阈值也会影响这俩指标。判断阈值调高,模型更谨慎,报出来的正例少而准,精确率上去了,召回率掉下来。阈值调低,宁错勿漏,召回率上去,精确率下来。考试给你一组数据,让你调整阈值平衡两个指标,思路就是这个跷跷板,一头高另一头必然低。
考试还有个坑,专门考概念。题目问你模型在验证集上表现最好,到测试集上明显下降,说明什么。选项里混着过拟合、欠拟合、数据没打乱、类别不均衡。听着都像,但标准答案只有一个:过拟合,而且是过拟合在测试阶段的表现。别被后面几个带偏,那几个是干扰项。
多分类的场景,还会碰到宏平均和微平均这俩词。宏平均就是每个类别单独算指标再求平均,类别少的小类不会被淹没。微平均把所有样本混在一起算,大类占主导。考试问什么时候用宏平均,答关注小类、类别不均衡的业务,准没错。
把这几个指标串起来记:准确率看整体,精确率看报得准不准,召回率看抓得全不全,F1看两头的平衡。考试给你一段业务描述让选指标,先问自己漏了行不行,再问报错了烦不烦,答案自然就出来了。
三、混淆矩阵怎么读
混淆矩阵就两行两列,真阳性、假阳性、真阴性、假阴性,缩写TP、FP、TN、FN。四级结果对应四个词,看着绕,其实记起来不费劲。
怎么记不混?我给学员一个笨办法:后面那个字是模型的判断结果,阳性就是模型说有。假阳性就是模型说有但实际没有,这是误报。假阴性是模型说没有但实际有,这是漏报。考试里误报率、漏报率一问一个准,分清这俩,分就到手。
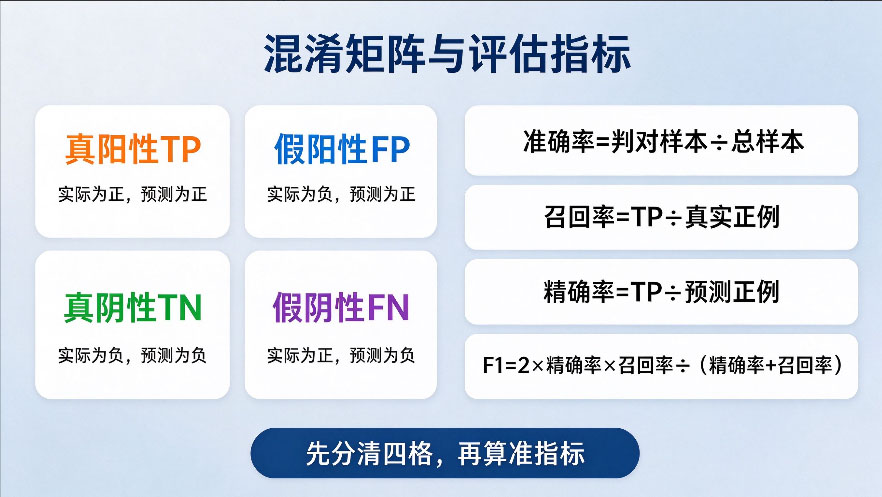
做题时给你一张表,先别着急算,先把格子归对位。真实类别写在左边,预测类别写在上面,这个顺序搞反,后面全错。我见过学员格子读反,整道大题白丢。
还有个考试常问的:错误预测一共几个?就是假阳性加假阴性。别再回头把真阳性真阴性也加进去,那是判对的。这种送分题丢了,太可惜。
拿一组数练一遍。比如真实正例80个、负例120个,模型判对了真阳性70个,真阴性110个,那假阳性就是10个,假阴性是10个。准确率等于判对的180除以200,得90%。召回率等于70除以80。精确率要换个口径,模型一共报了80个正例,其中70个是真的,精确率就是70除以80。数字一套进去,谁大谁小一目了然。
四、过拟合和欠拟合怎么治
模型在训练集上99分,换一批新数据只剩70分,这就是过拟合。模型把训练数据里的噪声也背下来了,像学生死记硬背答案,题一换就懵。
实操考核里也会碰到这种情况,你跑出来的结果看着比谁都漂亮,老师一问换批数据还成不成立,立马露馅。记住,考试要的不是漂亮分数,是你说得清这分数是怎么回事。
欠拟合正好反过来,训练集都考不及格。模型太简单,特征都没学明白,给它啥数据它都学不到点子上。
| 症状 | 判断依据 | 常用处理办法 |
|---|---|---|
| 过拟合 | 训练集分数高,测试集分数明显低 | 补充数据、简化模型、早停、正则化 |
| 欠拟合 | 训练集和测试集分数都低 | 换更复杂模型、增加特征 |
治过拟合的办法就这几条:加数据、简化模型、早停、正则化。三级考试问到这个层面基本够用,不用再往下钻算法细节。治欠拟合更简单,换个更复杂的模型,把特征做扎实。
正则化提一句。L1正则化会把不重要的特征权重压成零,自带筛选功能,解释性好。L2正则化把权重都往小了压,不让任何一个特征走极端。考试里给你一段描述,问哪种正则化能做特征选择,选L1就对。早停更好理解,验证集分数不再涨就停手,别再练了,练得越久越容易背过头。
话又说回来,考试不会让你手写算法,考的是判断。给你一组分数描述,问你是过拟合还是欠拟合。认出训练好测试差这六个字,答案就是过拟合,白给的分。
实际训练时怎么盯?就盯两条曲线。训练误差一路降,验证误差先降后升,那个拐点就是该停手的地方。两条都不降,说明模型压根没学进去,回去查数据和特征。这两条曲线长什么样,自己在平台上跑一遍就记住了,比背十遍书管用。
五、这块考点在培训班里怎么练
讲真,这些指标自己看书也能懂,但自己练和对着真平台练是两码事。看书时公式都认得,上考场换个说法就卡壳,这是学员里最常见的情况。
优培东方(广州慧翔企业管理咨询有限公司)做职业培训十几年,AI训练师这种人社部新职业是我们重点覆盖的品类,连同PMP、软考、CSPM、CISP、CISAW、ESG分析师一起排进课程体系。教研老师把模型评估这块拆成了指标计算、数据划分、调参实操几个模块,机房里直接在标注和训练平台上动手练,不是光坐在下面听理论。
我们这门课的实操课时占比不小,毕竟三级考试本来就有上机操作考核。学员在机房里把切数据、跑指标、读混淆矩阵这整套流程走几遍,考试时就是熟门熟路的事。
网络班覆盖全国各省市,北京、上海、广州、深圳这些城市有线下教学点。学员里不少是做数据工作想转方向的,最怕的就是概念混。我们把混淆矩阵这类内容做成当堂练的小题,做错当场讲,讲完再练一遍。考前想问问题,打400-956-6153就能找到教务老师。
话说回来,课只是拐杖,功夫还是要自己下。我们能做的是把考点拆碎、把平台摆到你面前,练还是得你自己练够。
这几个考点,建议考前一周集中刷。公式类的别背汉字,背公式。考场里时间够用,别慌。真遇到拿不准的判断题,记住一句话:凡是让测试集提前露面的操作,全是不规范的。
问题1:准确率和召回率到底先看哪个?
答1:看场景。诈骗识别、医疗筛查漏不起,先看召回率。推荐、广告别乱推,先看精确率。考试问哪个场景看哪个指标,按这个逻辑答基本不会错。
问题2:过拟合怎么判断?
答2:就看两组分数差多少。训练集分数明显高于测试集,差距拉大就是过拟合。两边都低是欠拟合。考场里看到训练集98%测试集72%这种描述,直接选过拟合。
问题3:训练集验证集测试集按什么比例分?
答3:常见6:2:2或7:2:1,数据多就把训练集比例拉大。考试记住测试集只在最后评估时用一次,拿测试集调参是大忌。
问题4:AI训练师三级考试这些内容占比大吗?
答4:模型评估与调优属于智能训练模块的核心内容,理论和实操都可能考。指标计算是实操里的常客,建议按必考准备,别押它不考。

 粤公安备案 44010602008731号