

 首页>
最近在备考人工智能训练师,把数据标注和模型调优这两块核心技能从头到尾啃了一遍,整理成自己的笔记。不管是刚入行想转AI训练师,还是已经在做标注想往模型侧走,这篇笔记都值得收藏对照着看。文章全程干货,中间会自然穿插一点我了解到的培训选择,不硬推。
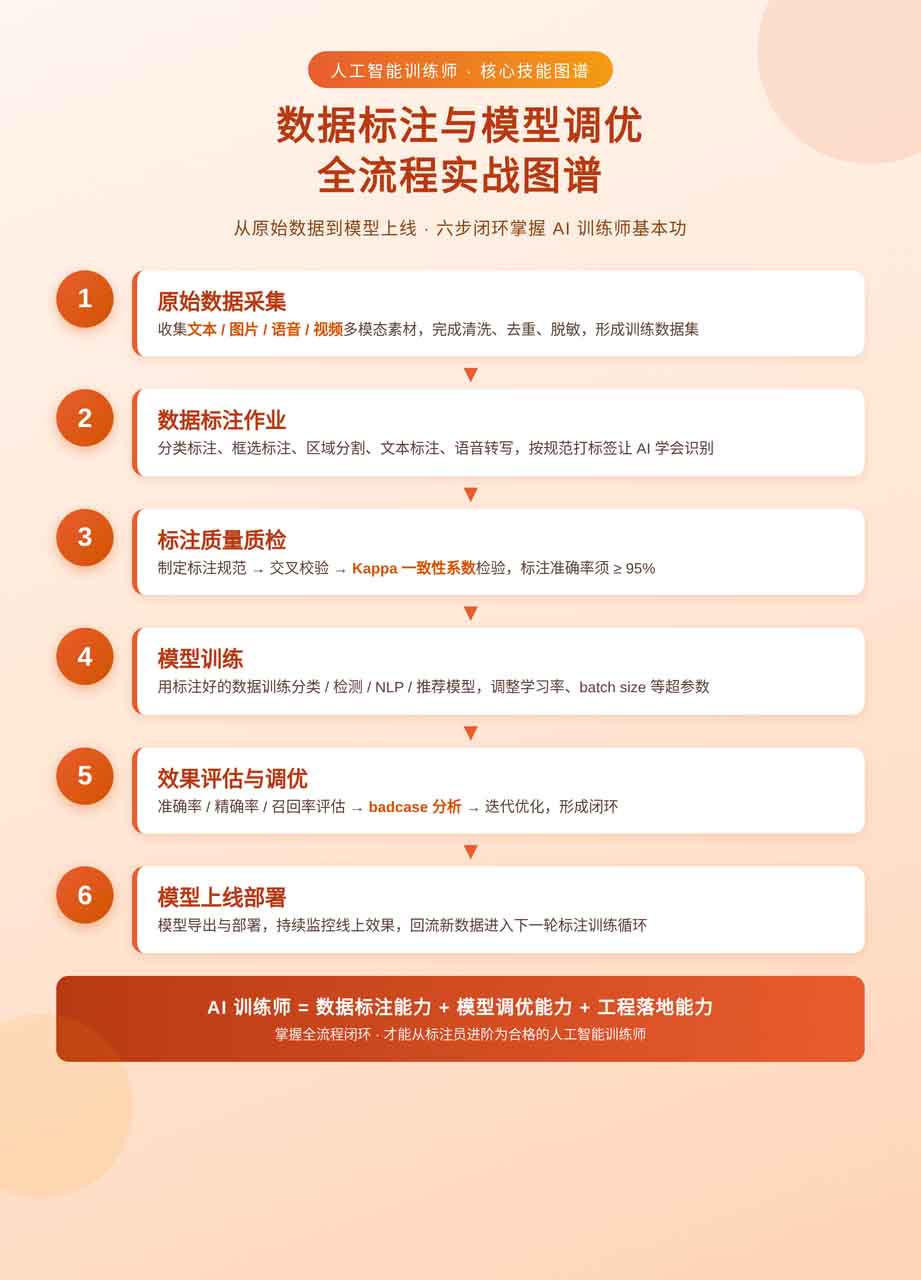
一、数据标注:AI训练师的入门基本功
1.1 数据标注到底是什么
说白了,数据标注就是给原始数据"打标签"。原始数据就是一堆没经过处理的文本、图片、语音、视频,AI本身不知道哪张图里是猫、哪句话是差评、哪段语音说的是什么。标注员的工作就是按照预先制定好的规范,把这些信息用标签、框、区域、转写文字等形式标出来,喂给模型去学习。
打个比方:AI像一个刚入学的小孩,你给他看一百张猫的照片,并告诉他"这是猫",他才能慢慢学会认猫。数据标注就是那个在旁边反复告诉他"这是猫"的过程。没有标注,再贵的GPU、再先进的算法都是空中楼阁——这也是为什么业内常说"数据和标注决定了模型的上限"。
作为人工智能训练师,不能只停留在"会点鼠标框框"的层面,要理解标注背后的逻辑:标签体系怎么设计、质量怎么控、不同模态数据怎么处理,这些才是拉开普通标注员和训练师差距的地方。
1.2 五种常见标注类型
备考这块要把每种标注类型的适用场景和产出格式记清楚,实操题经常让你判断"这个任务属于哪种标注"。
分类标注:给整个对象贴一个类别标签。比如一张照片判断"是猫还是狗",一段评论判断"正面还是负面",一段语音判断"是普通话还是粤语"。产出最简单,就是一个类别ID。
框选标注(边界框标注):用矩形框把目标物体圈出来,同时打类别标签。这是目标检测任务最常用的标注方式,比如自动驾驶里框出车辆、行人、红绿灯。产出是"类别+左上角坐标+宽高"。
区域标注(语义分割/实例分割):比框选更精细,要沿着物体轮廓一圈一圈描出来,精确到像素级别。比如医疗影像里标注肿瘤区域、自动驾驶里把可行驶区域整个勾出来。工作量大,但精度要求最高。
文本标注:针对NLP任务,包括分词、词性标注、命名实体识别(人名地名机构名)、情感分类、文本摘要、问答对构造等。大模型时代还多了"对话质量打分""回答是否有用"这类RLHF相关标注。
语音转写:把语音音频逐字转写成文字,还要标注静音段、说话人分离(谁在什么时候说话)、情绪标签等。智能客服、会议纪要、语音助手背后都靠这个。
1.3 标注质量控制三道关
考试和实操里最爱考质量控制。标得快不快是次要的,标得准不准才是硬指标。正规项目一般有三道关:
第一关:标注规范先行。开工前必须有一份详细的标注手册,写清楚标签定义、边界case怎么处理、什么情况算合格。规范越细,标注员之间的分歧越少。比如"行人"包不包括推婴儿车的人?"车辆"包不包括共享单车?这些都要在规范里写死。
第二关:交叉校验。同一份数据让两个甚至三个标注员独立标一遍,然后对比结果。如果两个人标得不一样,就进入第三方仲裁或者组长复核。一个项目里通常会留20%左右的数据做交叉标注。
第三关:一致性检验(Kappa系数)。这是高频考点。Kappa系数是用来衡量两个标注员之间一致性的统计指标,取值在-1到1之间。一般经验值:0.8以上几乎完全一致,0.6到0.8比较一致,0.4到0.6一致性一般,低于0.4说明规范有问题或者标注员没培训好,必须停下来重新对齐。项目验收时Kappa不达标,整批数据都要返工。
除了这三关,还有"抽检"和"金标准测试":组长按比例随机抽查标注结果;另外预埋一批已经标好标准答案的金样本混在任务里,标注员如果金样本都做错,说明他状态不对,要重新培训甚至淘汰。
1.4 常见标注工具盘点
工具不用全背,但主流的几个要知道特点和适用场景:
LabelImg:轻量级图像框选标注工具,开源免费,操作简单,适合个人做目标检测数据集。缺点是只支持矩形框,不支持分割,界面比较老。
LabelMe:MIT出的开源图像标注工具,支持矩形、多边形、圆形、线段、点等多种形状,适合做语义分割和实例分割标注。
CVAT:Intel开源的专业级图像/视频标注平台,网页端,支持团队协作、任务分配、自动预标注(可以先用模型跑一遍再人工修正),是目前工业界用得最多的开源方案。
百度EasyData:百度智能云旗下的一站式数据服务平台,提供文本、图像、语音、视频全模态标注,还有数据管理、模型训练一体的能力。国内企业项目用得很多。
另外还有阿里云的PAI-iTAG、腾讯的TI平台、京东的众智等,思路都差不多。了解工具的核心是理解"标注平台要解决什么问题":任务分发、进度追踪、质量校验、多人协同、格式导出。
二、模型调优:从标注到效果的关键一跃
2.1 模型调优是什么
如果说数据标注是"喂教材",那模型调优就是"根据学生的考试成绩调整教学方法"。标注好的数据喂给模型训练后,模型会输出一个初始效果,但这个效果通常达不到上线要求——要么准确率不够,要么在某些场景下误判很多。模型调优就是通过调整数据、参数、策略,让模型在目标场景下的效果持续提升的过程。
AI训练师和普通标注员最大的区别就在这里:标注员只管"标得对",训练师要管"模型最终效果好不好"。理解模型训练的基本逻辑、看得懂评估指标、能分析badcase、知道怎么迭代,这才是训练师的核心价值。
2.2 调优五步闭环流程
这是教材里反复强调的标准流程,必须背熟:
第一步:数据准备。把标注好的数据集按比例划分成训练集(一般70%到80%)、验证集(10%到15%)、测试集(10%到15%)。训练集用来训练,验证集用来调参,测试集用来最终评估。注意划分时要保持类别分布一致,不能把某一类全放训练集。
第二步:模型训练。选择合适的模型结构,设置初始超参数(学习率、batch size、训练轮次epoch等),开始训练。训练过程中观察损失函数loss是否下降、验证集准确率是否上升。
第三步:效果评估。不能只看准确率,要根据任务看指标:分类任务看精确率、召回率、F1值、混淆矩阵;检测任务看mAP;NLP任务看BLEU、ROUGE;推荐任务看点击率、转化率。不同指标之间可能此消彼长,要根据业务需求取舍。
第四步:badcase分析。把模型预测错的样本挑出来,归类分析:是数据标注错了?还是这类样本训练数据太少?还是模型结构不适合?还是输入数据本身有噪声?这一步最见功夫,很多人调优无效就是因为跳过了badcase分析,盲目调参。
第五步:迭代优化。根据badcase结论采取行动:补数据、改标注规范、调超参数、换模型结构、加正则化防过拟合,然后回到第二步重新训练。如此循环,直到效果达标上线。
2.3 四类常见模型
考试会让你根据业务场景判断该用哪类模型,先把四类模型的任务边界搞清楚:
分类模型:输入一个对象,输出它属于哪个类别。比如垃圾邮件识别、图片内容审核、客户流失预测。代表算法有逻辑回归、SVM、随机森林、ResNet等。
检测模型:不仅要判断图里有什么,还要框出它在哪里。比如自动驾驶识别车辆行人、安防监控识别异常行为。代表算法有YOLO系列、Faster R-CNN、SSD。
NLP模型:处理文本任务,包括文本分类、情感分析、机器翻译、问答系统、对话生成。大模型时代以BERT、GPT类模型为代表,训练师更多是做微调(fine-tune)和提示工程。
推荐模型:根据用户历史行为预测他可能喜欢什么。短视频、电商、新闻App背后都是推荐系统。涉及协同过滤、矩阵分解、深度学习排序等。
2.4 实操考点必背清单
我把实操和选择题高频考点整理成一张小抄,考前翻一遍:
标注准确率要求:一般项目要求标注准确率不低于95%,关键场景(医疗、金融)要求98%以上;Kappa系数不低于0.75才算合格。
常见标注错误类型:漏标(该标的没标)、错标(标错类别)、边界不准(框偏了或者分割轮廓不贴合)、重复标(同一目标标了两次)、规范不一致(不同人对同一边界case处理不同)。
调优基本参数:学习率(learning rate)一般从0.01、0.001、0.0001几个量级试;batch size常用16、32、64;epoch根据过拟合情况调整,一般10到100轮;过拟合时加dropout、L2正则化、数据增强;欠拟合时换更复杂的模型、加特征、训练更久。
数据集划分比例:常见7:2:1或8:1:1,类别不平衡时要用分层抽样。
三、写在最后:从笔记到拿证,培训怎么选
说实话,数据标注和模型调优这套东西,光看书记不住,必须动手练。我自己当时是在优培东方报的人工智能训练师培训班,他们是广州慧翔企业管理咨询有限公司旗下做职业培训的品牌,和中国中检陕西分公司有合作背景。广州这边三级班我记得是2380元全包,考完之后符合条件还能申请政府补贴3120元,算下来等于倒贴钱学技能。
我选它主要是三点:一是两年学籍可以重学,一期没学会下期免费再来,不用担心学一次就忘;二是三位一体督学,班主任、授课老师、教务都盯着你打卡,自己学容易偷懒;三是课程长期回放,上班摸鱼或者周末随时能补。对我这种白天要上班、晚上才能学的人比较友好。
当然,培训机构只是辅助,核心还是自己要把上面这些知识点啃透、把标注工具和调优流程亲手跑一遍。人工智能训练师这个职业现在需求涨得很快,从纯标注往"会调模型"的方向走,薪资和天花板都会高一个档次。笔记先整理到这里,后面备考有新的心得再补充。

 粤公安备案 44010602008731号